はじめに
DataTalksClubのMLOps Zoomcampで学んだことをoutputします。
参考動画
解説
import xgboost as xgb
from hyperopt import fmin, tpe, hp, STATUS_OK, Trials
from hyperopt.pyll import scope
ここがそもそも全然わからなかったので、概要だけ理解する。 xgboostは勾配ブースティングに基づいた機械学習アルゴリズムの1つ。並列処理ができることによる高速学習と、決定木ベースのアンサンブル学習(複数のモデルを組み合わせた学習)による高い精度が特徴とのこと。詳しくはこちら(https://devops-blog.virtualtech.jp/entry/20250312/1741767926)が参考になりそう。 hyperoptは、機械学習モデルのパラメータを最適化してくれるpythonのライブラリである。 fminには最小にしたい目的関数を記述する。
train = xgb.DMatrix(x_train, label=y_train)
val = xgb.DMatrix(x_val, label=y_val)
公式document(https://xgboost.readthedocs.io/en/latest/r_docs/R-package/docs/reference/xgb.train.html)をみた感じ、 学習データはxgb.DMatrixの形のみとある。 そのため、訓練データ、テストデータはそれぞれDMatrixに変える必要がある。
def objective(params):
    with mlflow.start_run():
        mlflow.set_tag("model","xgboost")
        mlflow.log_params(params)
        booster = xgb.train(
            params=params,
            dtrain=train,
            num_boost_round=1000,
            evals=[(valid,'validation')],
            early_stopping_rounds=50
        )
        y_pred = booster.predict(data=valid)
        rmse = root_mean_squared_error(y_true=y_val,y_pred=y_pred)
  mlflow.log_metric("rmse", rmse)
        return {'loss': rmse, 'status': STATUS_OK}
ここでは最小にしたい目的関数を返す関数を作成している。のちに、hyperoptのfmin使用時に設定する。 lossとstatusを返すようにしている。 xgb.trainの詳細はこちら(https://xgboost.readthedocs.io/en/stable/python/python_api.html)。
search_space = {
    'max_depth': scope.int(hp.quniform('max_depth', 4, 100, 1)),
    'learning_rate': hp.loguniform('learning_rate', -3, 0), # [exp(-3),exp(0)] = [0.05,1]
    'reg_alpha': hp.loguniform('reg_alpha', -5, -1), # [exp(-5),exp(-1)] = [0.006,0.36]
    'reg_lambda': hp.loguniform('reg_lambda', -6, -1), # [exp(-6),exp(-1)] = [0.002,0.36]
    'min_child_weight': hp.loguniform('min_child_weight', -1, 3), # [exp(-1),exp(3)] = [0.36,20]
    'objective': 'reg:linear',
    'seed': 42
}
こちらは探索空間を設定している。 今回最適化したいパラメータとその範囲を決めている。 hpは値を特定の範囲内でサンプリングするhyperoptライブラリのモジュール(部品)。 hpの公式documentはこちら。(https://hyperopt.github.io/hyperopt/getting-started/search_spaces/#defining-a-search-space) scopeはhyperopt.pyllのモジュールで、hpでサンプリングした後にかます変換関数のイメージ。
best_result = fmin(
    fn=objective,
    space=search_space,
    algo=tpe.suggest,
    max_evals=50,
    trials=Trials()
)
ここでhyperoptのfminを使用することで、ハイパーパラメータの調整を自動的にしてくれる。 fnが対象の目的関数(最小化したいやつ)、 spaceが対象のハイパーパラメータと範囲をまとめた探索空間、 algoが調整方法のアルゴリズム(TPEを使用)、 max_evalsが調整回数の上限、 trialsが試行方法である。
詳しいhyperopt.fminの参考資料はこちら(https://docs.databricks.com/aws/en/machine-learning/automl-hyperparam-tuning/hyperopt-concepts)。
これで実際に2時間程度学習します。 最終的には、「validation-rmse:9.40764」から「validation-rmse:5.88858 」くらいまで改善されます。
with mlflow.start_run():
    best_params = {
        'learning_rate' : 0.0842453986645059,
        'max_depth': 36,
        'min_child_weight': 7.741919852106371,
        'objective': 'reg:linear',
        'reg_alpha': 0.12023902213678989,
        'reg_lambda': 0.06371166574210547,
        'seed': 42
    }
    mlflow.log_params(best_params)
    booster = xgb.train(
            params=best_params,
            dtrain=train,
            num_boost_round=1000,
            evals=[(valid,'validation')],
            early_stopping_rounds=50
        )
    y_pred = booster.predict(data=valid)
    rmse = root_mean_squared_error(y_true=y_val,y_pred=y_pred)
    mlflow.log_metric("rmse", rmse)
    mlflow.xgboost.log_model(booster, artifact_path='models_mlflow')
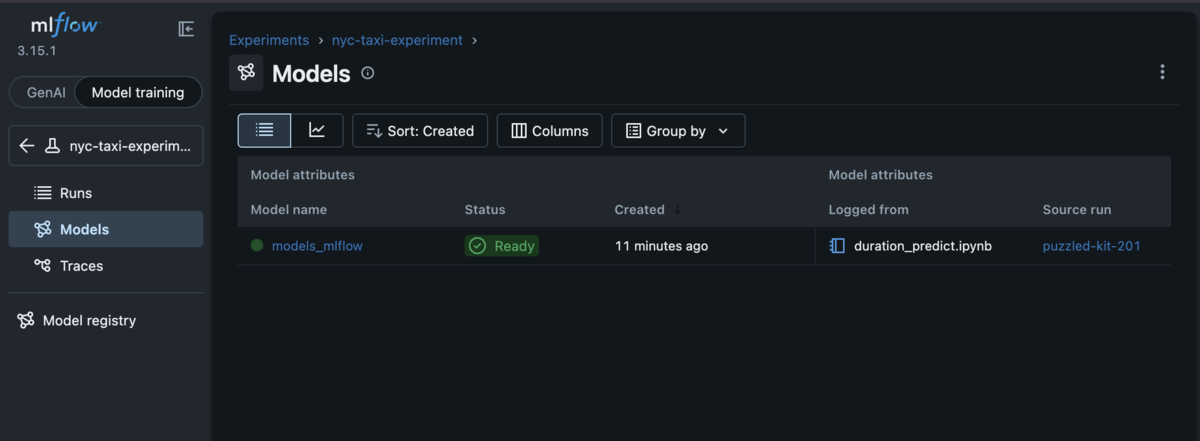
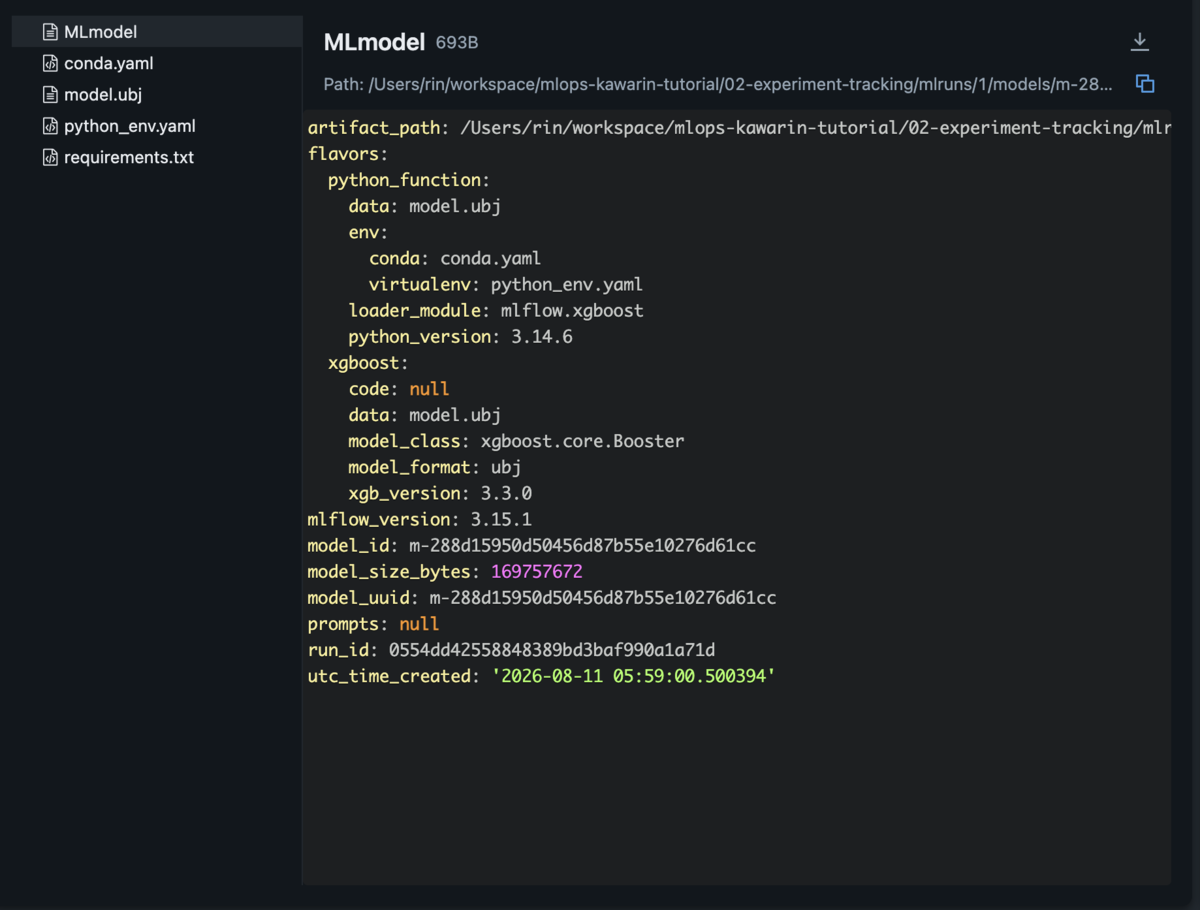
mlflow側のローカル画面から実際にrmseが最小のものを見つけ、そのパラメータをbest_paramsとして再度評価をし、 modelとして保存している。mlflow.xgboost.log_modelを使用することで、下記のように、modelが保存される。

最後に
モデルのデータをmlflow側に残す方法についてある程度理解できました。 特にhyperoptやxgboost等の使い方がわかりました。 また、PytorchやTensorflowでも同様にmlflowとの連携ができるっぽいので、今後そちらでもやってみたいです。